
围绕注意力去设计
模型越来越聪明、越来越快。真正的瓶颈变成了我们自己:一个人一天能做多少决定。Hey Atu 的所有设计,都从这一点出发。
瓶颈已经转移
过去几年,大家关心的问题是“模型能不能做到”。所以我们写更好的提示词、搭更长的工作流、接更多的工具,因为模型是那个短板。
对大部分日常工作来说,这已经不成立了。一个好模型加一个很薄的 harness,就能查资料、写东西、改代码、盯价格、整理发票,而且比我读完它的过程还快。
于是瓶颈转移到了人身上。我还是只有一个脑子、一天的时间。Agent 每完成一件事,最后都需要我:做个选择、批准一下、说一句“发吧”,或者只是知道这件事已经完成了。这些决定,每一个都要用注意力来支付。
瓶颈在模型。
做更强的 harness,加更多的 skill。瓶颈在人。
让每一个决定花更少的注意力。这就是整个产品背后的那一个想法。Hey Atu 主要不是一个写代码的工具,也不只是手机上的一个聊天 App。它想做的是:让你用更少的注意力,处理更多的工作和生活里的事。
注意力的四个层级
这套设计来自我自己十几年工作积累下来的习惯。我觉得它对学生也同样适用:只要你同时在处理很多条线,有的很急,大部分不急。
不是所有的事都需要你在同一时刻处理。有的事现在就需要你;有的事今天要处理,但不是这一分钟;有的事只要在它完成时看一眼;还有的事,只属于你有空思考的时候。
Hey Atu 有四个 tab,每个 tab 就是其中一个层级:
- 1Chats现在。对话、决策、给反馈。
- 2Todo稍后,不是现在。需要之后处理的事。
- 3UpdatesAgent 做完之后。看一眼结果。
- 4Wiki有空的时候。整理自己的思考。
第一级Chats:此刻的注意力
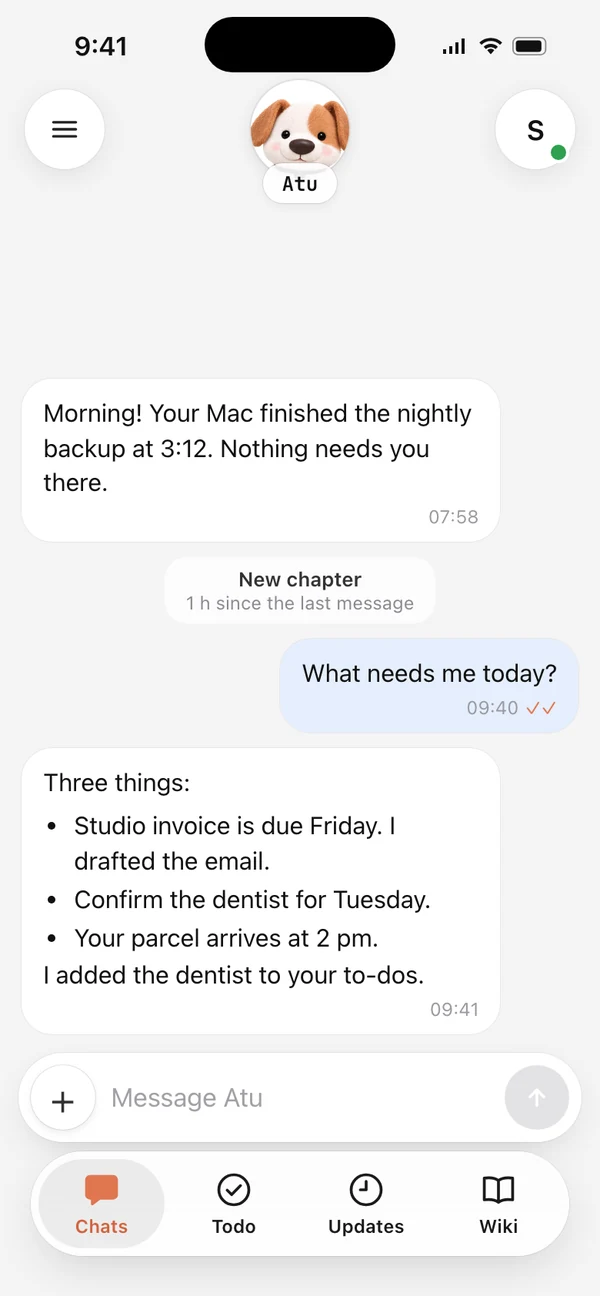
沟通是第一级的需要。它是你和 Agent 一起思考的地方:你提问,它去做,你来决定,你来纠正。这是最贵的一种注意力,因为它是实时的。
所以 Chats 必须保持小。只有需要你现在回复的内容才属于这里,其它的都应该往下放一层。Agent 回来找你的时候,先给结论,再把选项放在旁边,这样你在手机上、在两件事的间隙里,一句话就能做决定。
第二级Todo:你和 Agent 共享的待办
这一块比较特别,也是我最喜欢的。
2025 年,Claude Code 让“Agent 自己的 ToDo”流行起来:Agent 先写计划,再一项项勾掉,在长任务里不跑偏。那套 ToDo 是为 Agent 设计的。到了 2026 年,模型变强了,它的作用越来越小,Claude Code 也在最新的模型上默认关掉了这些 ToDo 工具。模型已经足够强,自己就能把整个任务跟完。
但人的脑子仍然需要 ToDo。我们脑子里总有各种随机冒出来的想法、要跟进的事、“回头得查一下”的念头。每一个在被写下来之前,都占着一小块注意力。
我以前读过 David Allen 的《Getting Things Done》(GTD)。其中一条原则一直影响着我:把脑子里的事全部拿出来,放进一个看得见、信得过的地方。大脑是用来产生想法的,不是用来存放想法的。
> Fix the wrong dates on the invoices

● Update Todos
  ⎿  ☒ Read the failing test
     ☒ Find where dates are parsed
     ☐ Use the customer’s time zone
     ☐ Run the tests again
Agent 为一个任务做计划、逐项勾掉。任务结束,清单也就结束了。
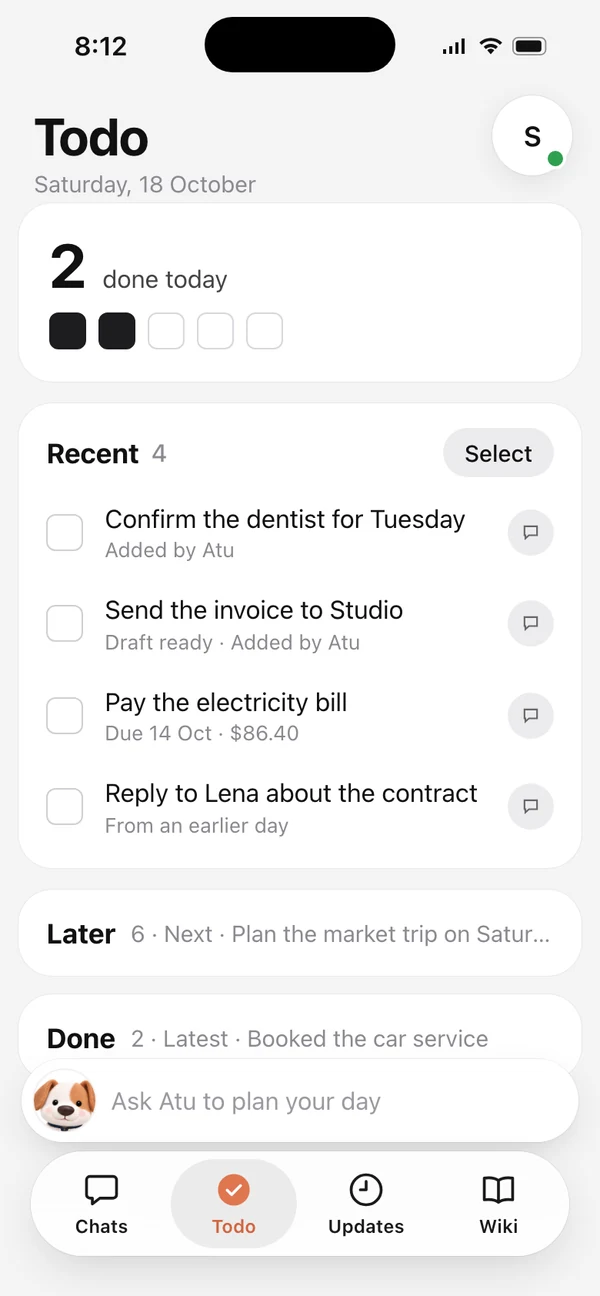
所以 Hey Atu 的 Todo 是一份你和 Agent 共同维护的清单:
- 同一份清单,同样的操作。你在手机上添加、移动、完成;Agent 通过命令行做同样的事。每一次改动都记录是谁做的,每一次都能撤销。
- 从聊天里来。在任何对话里说一句“周五提醒我跟进 Sam”,它就进了清单。一条待办也能直接打开一个对话,从你记下它的地方开始干活。
- 由 Agent 保持它是真的。我们正在做下一步:Atu 会读你已经结束的对话。做完的事放进 Done;停在半路、等你回复的对话,变成一条待办,只写一行:它需要你给什么。
结果是你不用再记着那些没收尾的事。看一份清单,就知道还剩什么。
第三级Updates:不打扰你的结果
Updates 很接近其它产品里的定时任务(Schedule):“每天早上看一下这个价格”“构建跑完告诉我”“六点帮我总结一下收件箱”。你不在的时候,Agent 在干活。
关键在于结果怎么回到你这里。这些结果大多是日常的:一次监控没发现新东西,一次同步成功了,一份报告晚点再看。它们不值得占用一个对话,更不值得把你从正在做的事情里拉出来。
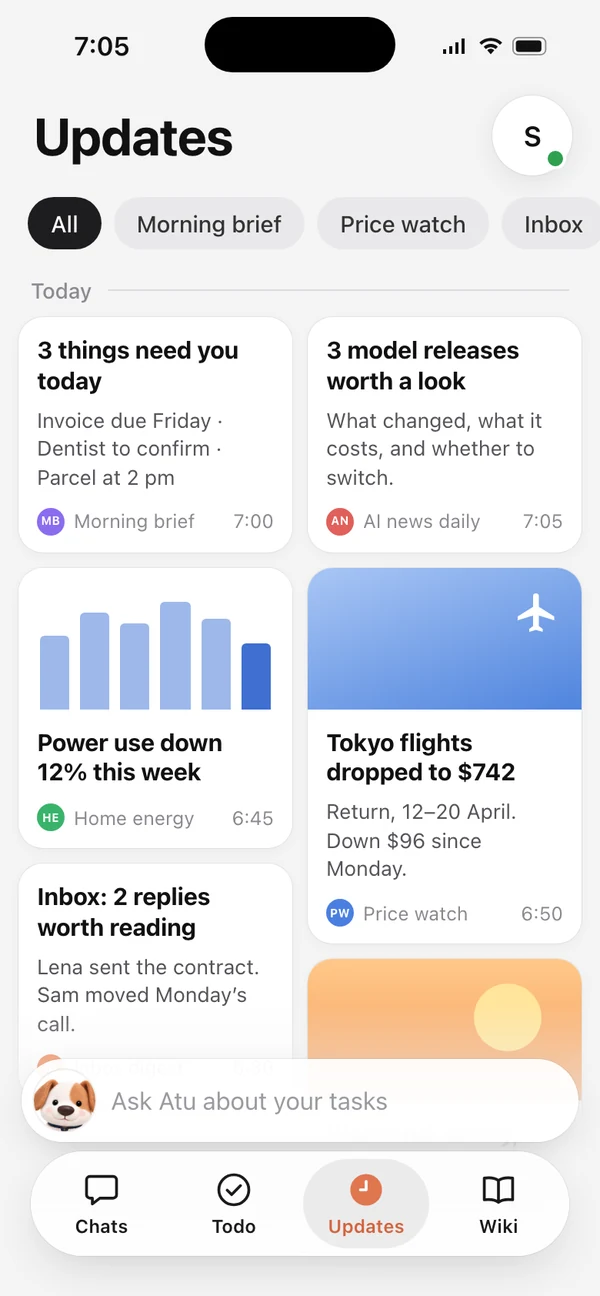
所以它们落在 Updates 里,是一个简单的信息流,你方便的时候再看。如果某个结果真的需要你决定,它就往上走一层:点一下就能开始一个对话,或者变成一条待办。提醒的门槛也由你来定,比如“降到 1300 以下再告诉我”。
第四级Wiki:把知识变成记忆宫殿
最后一级是知识。它最不急,但长远来看,也许最重要。
我们一直在学习:从文章、从书,也越来越多地从和 Agent 的对话里。对话里一个好的回答就是真正的知识。可是对话一往下滚,知识也跟着不见了。
知识只有在你回过头去复习的时候,才真正变成你的。背过单词的人都知道遗忘曲线:复习过的才记得住,而且每次间隔可以拉长一点;不复习,几天之内大部分就忘了。
Wiki 的设计参考了 Andrej Karpathy 的 LLM Wiki 理念:让 Agent 维护一组纯 Markdown 页面,知识一点点积累起来,而不是每次提问都重新去找。在 Hey Atu 里它是这样工作的:
- 你只负责添加。对话、链接、文件、笔记、Mac 上的文件夹,都可以。你不用整理,也不用打标签。
- Atu 来写页面。每个页面是一个长期的主题,之后的新来源会不断补充进去,页面之间互相链接。
- 在你睡觉的时候生长。每天夜里,Atu 把当天的新知识补进去;每周再整理一次结构:合并、拆分、补链接。
- 把内容带回你面前。Wiki 会告诉你昨晚和这周新增了什么,让你经常复习一点,而不是从来不复习。
# 日本旅行

## 概览
四月去两周。先京都,再大阪。

## 我的看法
“少去几个城市,每个地方多待几天。”

相关:[[四月的京都]] · [[要不要买 JR Pass]]
互相链接的纯 Markdown 页面。Atu 来写,你来读。
AGENTS.md
- 一个页面是一个长期的主题。
- “我的看法”只保留我自己的原话。
Atu 怎么写。你纠正一个页面时,Atu 会把这条规则加进来。
我把它看作一座记忆宫殿(memory palace)。标签是书,分组是章节,页面是正文。你的知识有了一个可以走进去的形状,你能看到自己知道什么,也能再找到它。而且这一切都是你自己电脑上的普通文件。
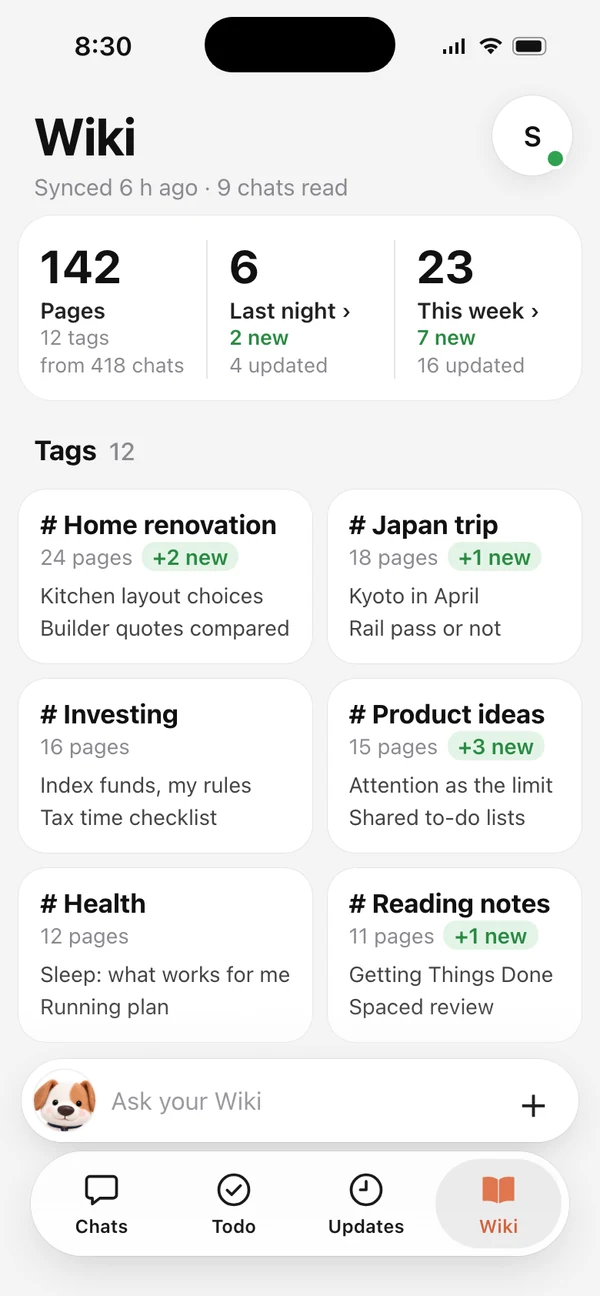
Wiki 从不要求你做决定,也没有“必须读”的压力。它只是在你有空的时候等着你。
内容在层级之间流动
四个层级不是四个孤岛。内容会流动,而且 Agent 可以替你去移动它:
每做一个新功能,我都会用一个问题检验它:当模型强两倍的时候,它还有用吗?很多精巧的 Agent 工作流过不了这一关,因为下一代模型会让它们变得多余。而节省人的注意力能过这一关。Agent 越强,完成的工作越多,这些工作怎么回到你面前就越重要。
这就是 Hey Atu 要做的事。
Hey Atu 让你的 AI 运行在你自己的电脑上,并且可以在手机上使用。现在就能试用,免费 100 次操作。
开始使用